VoiceTra 一键语音翻译——说话即翻译的核心功能
核心链路:四步完成一次翻译
你按下麦克风、说完话、松开按钮之后,VoiceTra 在云端完成四个步骤:
语音输入 → 语音识别(STT) → 机器翻译(MT) → 语音合成(TTS)这四项技术全部来自日本 NICT 的研究成果。处理完后,结果回传到你的手机上显示和朗读。
界面上的三段显示
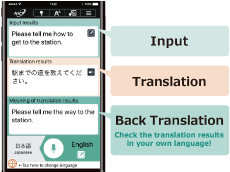
翻译完成后,屏幕上会依次显示三行内容:
第一行:输入识别结果
这是你的语音被识别成的文字。如果识别对了,说明语音识别这一步成功。
第二行:翻译结果
这是翻译后的目标语言文字。这是对方要看的内容,同时会通过语音朗读出来。
第三行:回译确认("译意确认")
这是翻译结果再次翻回你自己语言的版本。用来检查翻译是否正确——如果回译出来的意思和你原本想说的对不上,说明翻译有偏差。
长按还是点击
VoiceTra 的麦克风按钮支持按下说话、松开停止的交互模式。按下过程中会有一个计时器,最长 30 秒。
为什么是长按而不是点一下开始、再点一下停止?因为长按更自然——说话的同时手指按着,说完就松开,没有多余的操作。而且长按能让 VoiceTra 更准确地判断你什么时候说完。
云端处理的含义
所有这四步都在 NICT 的服务器上完成,而不是在你的手机本地。好处是:
- 手机不需要强劲的芯片
- 模型可以随时在云端更新,不需要你升级 App
- 翻译效果持续改进
代价是必须联网。断网时翻译功能完全不可用,但翻译历史依然可以查看。
一次翻译的数据消耗
根据官方数据,一次完整的语音翻译过程(从按下麦克风到结果返回)大约消耗 100KB 的网络流量。其中大部分是上传的语音数据和下载的翻译结果。
单次输入时长限制
VoiceTra 限制单次语音输入最多 30 秒。如果你说了超过 30 秒,后半段会被截断。这个限制和大多数在线语音翻译工具一致。
建议把想要表达的内容拆成几句来说,每句不超过 20 秒最稳妥。不仅能避免截断,也能让翻译结果更准确——短句子比长句子更容易翻译对。